
Hola a todos, seguimos la serie de posts sobre planes de ejecución en SQL Server. Después del post con algunos tips para optimizar consultas SQL y del post mostrando qué son los planes de ejecución en SQL Server vamos a ver como podemos controlar los planes de ejecución de nuestras consultas con el uso de Hints.
Tipos de Hints en SQL Server
Un hint es una instrucción que se incluye en la consulta para influir en cómo el motor de base de datos ejecuta esa consulta. Los Hints no cambian el resultado de la consulta, solamente pueden afectar al plan de ejecución de la misma.
Es importante destacar que los Hints son peligrosos, ya que provocan que el optimizador no tome decisiones en la revisión de la consulta para ofrecer un plan de ejecución, y solo deben utilizarse cuando sea completamente necesario. Un buen uso de los Hints puede mejorar el rendimiento de una consulta, pero un mal uso de ellos puede provocar bloqueos y lentitud en la aplicación.
Los Hints se dividen en 3 categorias
– Query Hints – El optimizador aplica el Hint en la ejecución de la query completa
– Join Hints – El optimizador aplica el Hint para un Join concreto de la query
– Table Hints – Controla los Table Scans y el uso de un índice concreto de la tabla
Query Hints
Este tipo de Hints es el más amplio, y entraremos en ellos en un post más adelante. Hay varios Hints que se ofrecen para mejorar el rendimiento en querys completas.
La sintaxis de este tipo de Hint se realiza con la clausula OPTION al finalizar la consulta.
SELECT C.Nombre, V.FechaVenta, V.Total
FROM Clientes C JOIN Ventas V ON C.IdCliente = V.IdCliente
WHERE …
OPTION (<hint1>, <hint2>)
Join Hints
Los Join Hints se usan para forzar el tipo de algoritmo de Join que el optimizador debe utilizar al combinar dos tablas. Existen 3 tipos de Hints para utilizar en los Joins.
- Nested Loop: Compara cada fila de una tabla («Outer Table») con cada fila de la otra tabla («Inner Table») y devuelve las filas que cumplen la condición. Este tipo de Join es ideal cuando una de las tablas es pequeña o tiene un índice eficiente.
- Merge Join: Compara las dos tablas si están ordenadas por la columna de Union. Es eficiente en grandes conjuntos de datos ordenados cuando hay índices.
- Hash Join: Se crea una tabla Hash en memoria para una de las tablas y compara con la otra. Es eficiente cuando en grandes conjuntos de datos desordenados sin índices.
La sintaxis para este tipo de Joins es:
SELECT C.Nombre, V.FechaVenta, V.Total
FROM Clientes C [LOOP | MERGE | HASH] JOIN Ventas V ON C.IdCliente = V.IdCliente
WHERE …
Para comprender el buen uso de estos Hints se puede ver con un ejemplo en la BBDD de ejemplo AdventureWorks2008R2, que se puede descargar aquí.
Ejecutamos una consulta de ejemplo
SELECT pm.Name, pm.CatalogDescription, p.Name AS ProductName, i.Diagram
FROM Production.ProductModel pm
LEFT JOIN Production.Product p ON pm.ProductModelID=p.ProductModelID
LEFT JOIN Production.ProductModelIllustration pmi ON pm.ProductModelID=pmi.ProductModelID
LEFT JOIN Production.Illustration i ON pmi.IllustrationID=i.IllustrationID
WHERE pm.name like '%Mountain%'
ORDER BY pm.name
Esta consulta, al tener una transformación con LIKE en la parte de WHERE, no puede utilizar un índice de manera eficiente. Por esto, revisando el plan de ejecución, se encuentra que la unión entre las tablas Product y ProductModel se realiza con un HASH JOIN, con un coste del 46% de la query. Una vez que se hace el Join, se ejecuta el ORDER BY y se ordenan las filas.
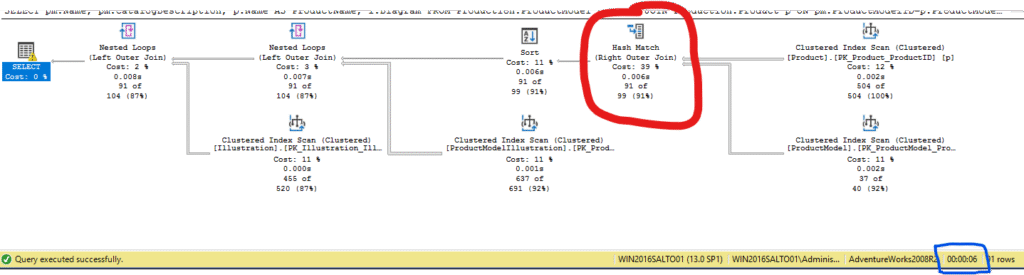
Si utilizamos el Hint MERGE, cambia radicalmente el plan de ejecución con respecto a esas tablas.
SELECT pm.Name, pm.CatalogDescription, p.Name AS ProductName, i.Diagram
FROM Production.ProductModel pm
LEFT MERGE JOIN Production.Product p ON pm.ProductModelID=p.ProductModelID
LEFT JOIN Production.ProductModelIllustration pmi ON pm.ProductModelID=pmi.ProductModelID
LEFT JOIN Production.Illustration i ON pmi.IllustrationID=i.IllustrationID
WHERE pm.name like '%Mountain%'
ORDER BY pm.name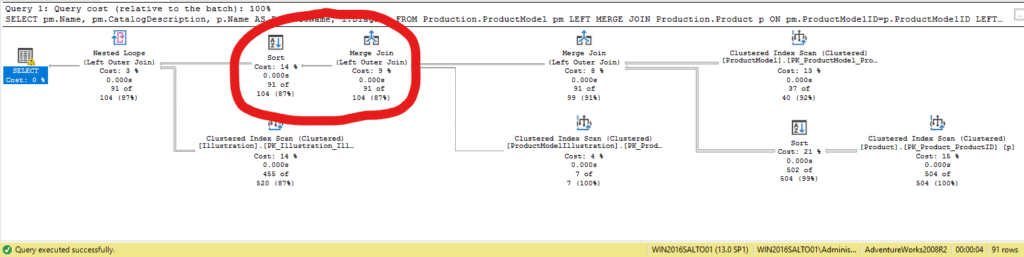
En este caso se hace un Merge Join y Sort, necesario para la ordenación, y con un coste mucho menor que el que tenemos con el HASH JOIN. Además, se puede ver que pasa de tardar 6 a 4 segundos, con lo que se obtiene una ganancia importante de tiempo.
Se puede revisar qué ocurre, si se realiza un Nested Loop en la query.
SELECT pm.Name, pm.CatalogDescription, p.Name AS ProductName, i.Diagram
FROM Production.ProductModel pm
LEFT LOOP JOIN Production.Product p ON pm.ProductModelID=p.ProductModelID
LEFT JOIN Production.ProductModelIllustration pmi ON pm.ProductModelID=pmi.ProductModelID
LEFT JOIN Production.Illustration i ON pmi.IllustrationID=i.IllustrationID
WHERE pm.name like '%Mountain%'
ORDER BY pm.name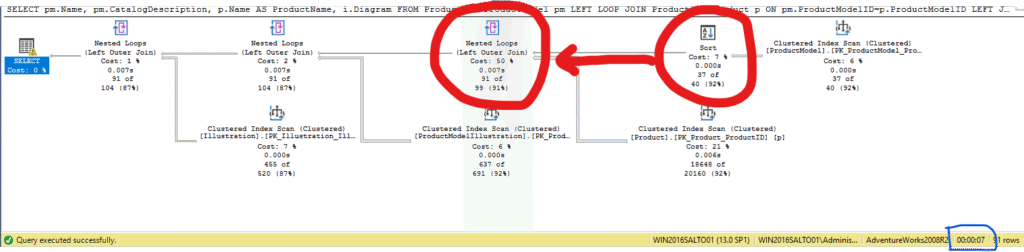
Si se utiliza el LOOP, lo primero que vemos es que ha tardado 7 segundos, es decir, más tiempo que sin Hint, con lo que ya vemos que no es una solución efectiva. En vez del HASH JOIN o el MERGE JOIN de la unión de las tablas, en este caso se utiliza un Nested Loop, y al no poder usar el índice, la comparación de las filas hace que el coste de la operación suba al 50% de la query. Además, antes de esto hay que realizar el SORT para la ordenación de los datos, lo que aumenta aún más el coste.
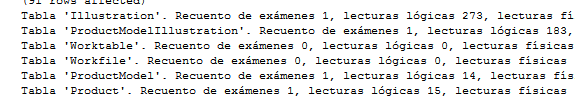
Si se revisan las estadísticas de las 3 ejecuciones, se puede comprobar lo mismo que revisando el plan de ejecución.
Sin Hint (HASH JOIN)
MERGE JOIN
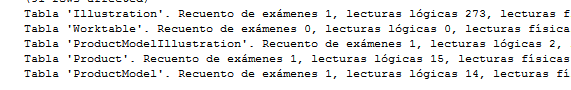
LOOP JOIN
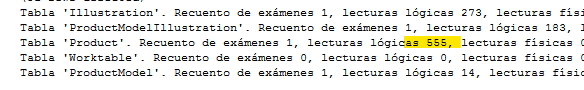
Se ve claramente en las estadísticas de ejecución de las querys, que cuando se utiliza el Hint MERGE hay una disminución drástica de lecturas sobre la tabla Products sobre el Hint LOOP, que hace 555 lecturas de la tabla, y en la tabla ProductModelIllustration, donde tanto sin Hint como con el Hint LOOP se realizan 183 lecturas, y con el Hint Merge solamente 2 lecturas. Aquí se encuentra la diferencia de costes y tiempo de ejecución, y se ve que el Hint MERGE en este caso es el Hint correcto.
Table Hints
Los table Hints son Hints que se utilizan para controlar como el optimizador trata una tabla en particular.
La sintaxis genérica de este Hint es la siguiente:
SELECT *
FROM Clientes WITH (<hint1>, <hint2>...)
Se puede comprobar con un ejemplo
SELECT de.name, edh.*
FROM HumanResources.Department AS de
JOIN HumanResources.EmployeeDepartmentHistory AS edh ON de.departmentID=edh.departmentID
WHERE de.name like '%P%'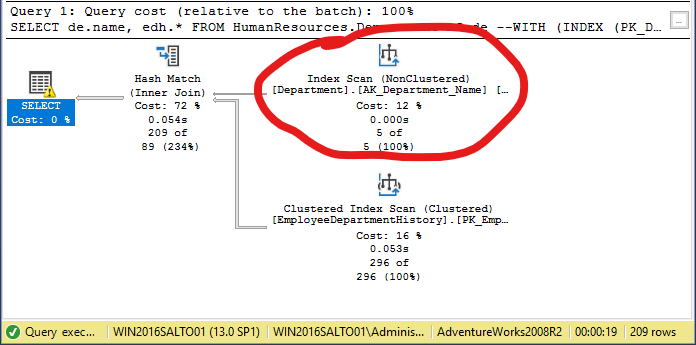
Si no se utiliza el hint, el optimizador decide utilizar un índice para la columna name de la tabla departments, y la consulta tarda 19 segundos en ejecutarse. Quizás habiendo un Join y teniendo un índice por la columna DepartmentID sería recomendable utilizar ese índice para favorecer la unión de las tablas. Para ello utilizamos el hint INDEX sobre el índice de la tabla Departments
SELECT de.name, edh.*
FROM HumanResources.Department AS de WITH (INDEX (PK_Department_DepartmentID))
JOIN HumanResources.EmployeeDepartmentHistory AS edh ON de.departmentID=edh.departmentID
WHERE de.name like '%P%'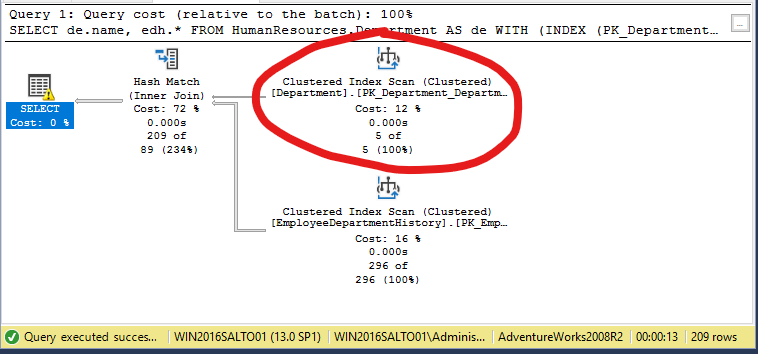
Con esto se fuerza a utilizar el índice, y la consulta pasa a tardar 13s, y aunque los porcentajes de los costes no cambian casi nada, se comprueba en los tiempos de cada una de las operaciones, que es 0, menos que en la ejecución sin índices.
Esperamos que esta aproximación al uso de hints os haya resultado de utilidad. No dudéis en poneros en contacto con nosotros en caso de necesitar ayuda en la gestión de vuestras bases de datos. Échale un vistazo a nuestros servicios de soporte y mantenimiento SQL Server y Oracle.
¿Aún no conoces Query Performance? Descubre cómo puede ayudarte en tu entorno Oracle. Más información en su página de LinkedIn.
Sígue a GPS en LinkedIn